
Un modello AI quantizzato usa una rappresentazione più compatta dei propri pesi. Questo può ridurre lo spazio necessario per caricarlo e renderne più pratico l’uso su un computer personale. Il compromesso riguarda memoria, compatibilità e, in alcuni casi, qualità o velocità: il numero di bit da solo non dice quale file funzionerà meglio sul tuo dispositivo.
Che cosa significa quantizzare un modello
Durante l’addestramento e l’inferenza, i pesi del modello sono numeri. La quantizzazione li rappresenta con una precisione inferiore, per esempio usando formati a 8 o 4 bit invece di formati più ampi. Hugging Face descrive l’obiettivo come ridurre la memoria necessaria cercando di preservare quanto più possibile l’accuratezza; esistono però metodi diversi, con vantaggi e limiti propri. Panoramica sulla quantizzazione di Transformers.
Il risparmio teorico si può stimare con una semplice formula: numero di pesi moltiplicato per i bit usati, diviso otto. Per esempio, sette miliardi di pesi memorizzati a quattro bit corrisponderebbero a circa 3,5 miliardi di byte per i soli pesi. Il file reale può essere più grande: entrano in gioco scale, metadati, tensori conservati a precisione maggiore e dettagli del formato. Non è una misura della RAM necessaria per eseguire il modello.
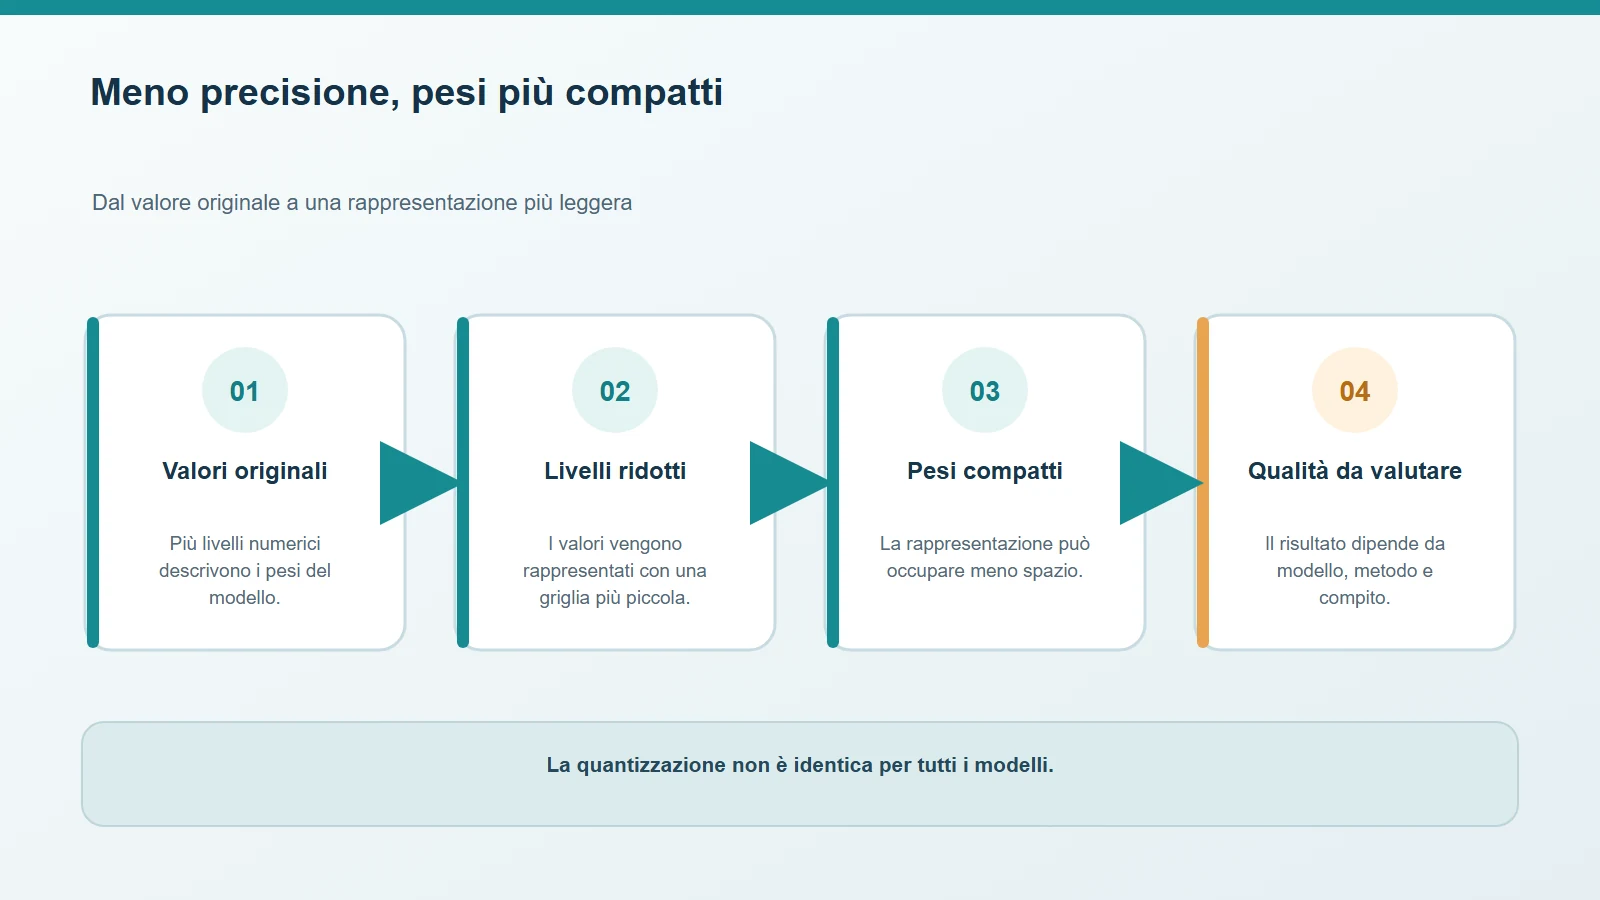
Una rappresentazione a precisione inferiore può ridurre lo spazio dei pesi, con risultati che dipendono dal modello e dal metodo.
Perché il file non basta a stimare la memoria
Quando il modello risponde, il computer deve gestire anche il programma che lo esegue, i buffer e la cache KV, che conserva informazioni utili mentre il testo viene elaborato. La memoria richiesta può quindi superare la dimensione del file scaricato. La cache cresce anche in funzione del contesto e delle impostazioni di generazione: una configurazione che si carica può diventare stretta quando si aumenta la lunghezza delle conversazioni o si elaborano più richieste.
La documentazione di Hugging Face distingue i metodi disponibili per formato, hardware e funzionalità, e considera anche la memoria della cache KV nel calcolo di compatibilità. Per questo è più utile controllare la memoria complessiva stimata dal runtime scelto che affidarsi solo all’etichetta “4 bit”. Metodi e formati supportati.
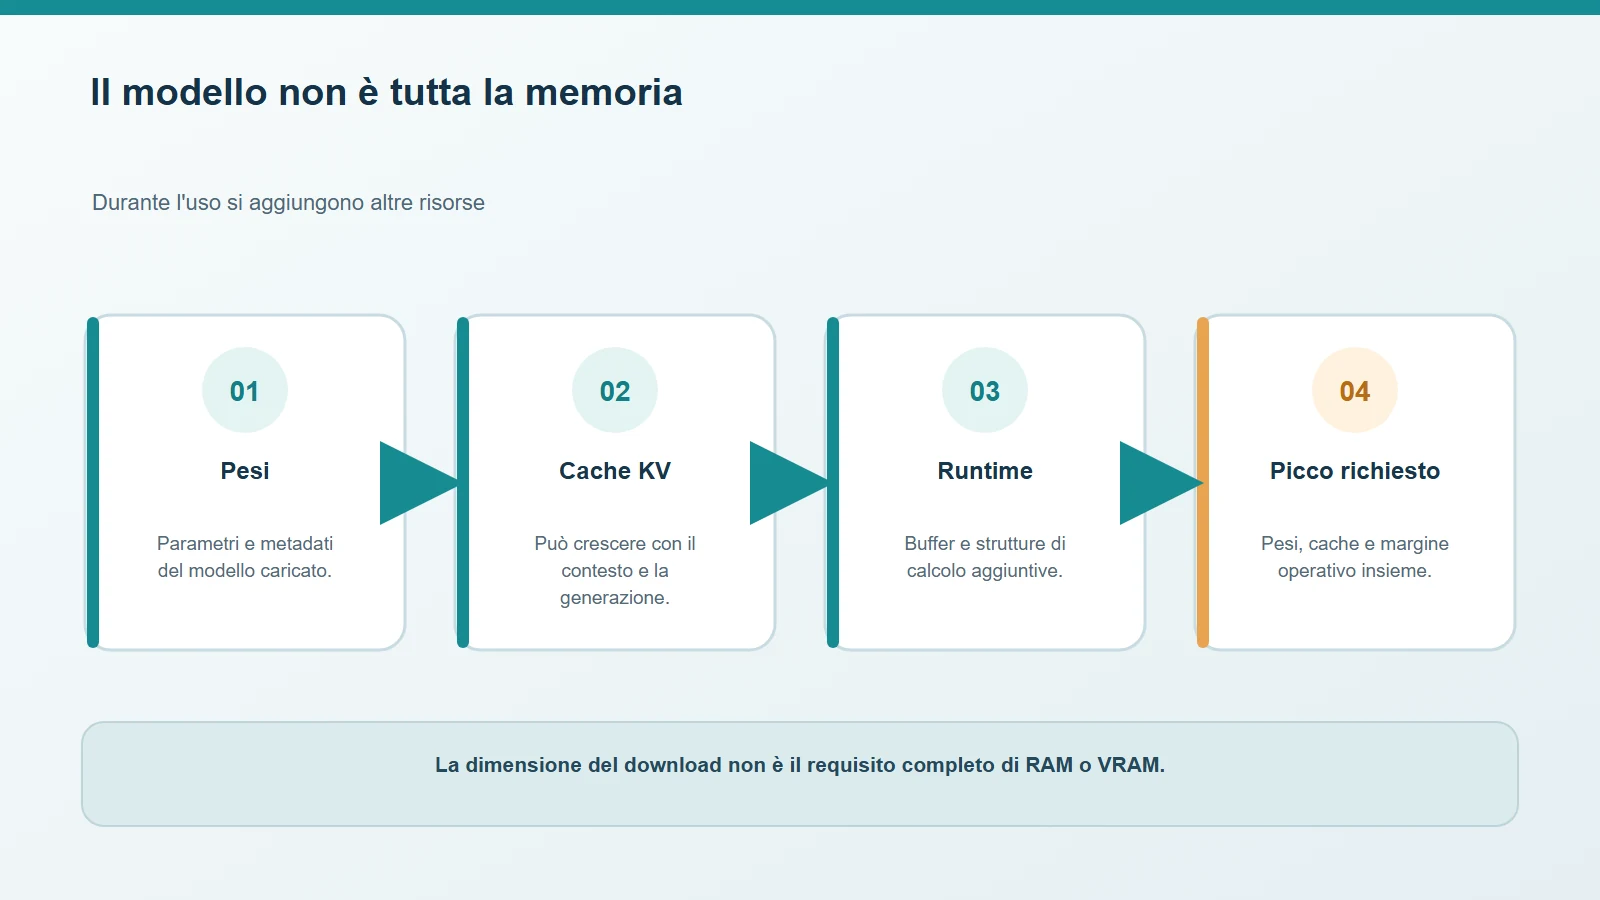
La memoria di lavoro comprende anche cache e runtime.
4 bit non significa sempre la stessa cosa
Il nome del file spesso indica una famiglia o una configurazione di quantizzazione, ma formati diversi possono usare tecniche, raggruppamenti e livelli di precisione differenti. Anche il supporto dipende dall’applicazione: un file compatibile con un runtime può non essere apribile con un altro, oppure può richiedere un backend specifico per CPU o GPU.
Neppure la velocità è garantita dal numero più basso. Una rappresentazione compatta può ridurre i trasferimenti di memoria, ma il runtime deve saperla elaborare in modo efficiente e l’hardware deve supportare le operazioni necessarie. Alcuni metodi aggiungono passaggi di conversione; altri sono ottimizzati per determinati processori. Senza una prova sullo stesso computer, modello e attività, non è corretto promettere che la versione quantizzata sarà sempre più rapida.
Come scegliere un modello quantizzato
Prima del download controlla:
- il formato richiesto dall’app che usi e la compatibilità con il tuo processore;
- la dimensione del file e la memoria totale stimata, inclusa la cache;
- la lunghezza di contesto che ti serve e quante richieste vuoi gestire insieme;
- la scheda del modello, la licenza e le istruzioni di chi lo distribuisce.
Se puoi, prova il modello con alcune richieste simili a quelle che userai davvero e confronta le risposte con la versione a precisione maggiore. Valuta completezza, precisione e stabilità, non soltanto quanto rapidamente si apre. I risultati di un benchmark pubblicato altrove non descrivono automaticamente il tuo computer.
La quantizzazione è utile quando un modello non entra nella memoria disponibile o quando vuoi ridurre lo spazio occupato. Se la versione originale funziona già bene e la memoria non è un problema, ridurre la precisione può non portare un vantaggio pratico. Per scegliere fra esecuzione locale e servizi online, leggi anche la guida sull’AI locale o cloud; per capire l’accelerazione dedicata ai modelli, consulta NPU e TOPS nei PC AI.
Commenti
Commenti
Partecipa con rispetto: le critiche motivate sono benvenute; evita minacce, insulti, dati personali e link promozionali.
Per partecipare alla discussione sarà necessario accedere con il proprio account WordPress.com. La funzione sarà disponibile all'apertura del sito.